Управление обновлениями (patch management)
Управление обновлениями (patch management) это непрерывный процесс отслеживания, тестирования и установки обновлений, закрывающих известные уязвимости, а не обновление только тогда, когда что-то сломалось.
Почему 'обновлять, когда что-то сломается' не является стратегией
Ожидание видимого сбоя как триггера для обновлений означает, что каждая известная, уже исправленная уязвимость остаётся неустранённой всё это время, а это именно то окно, на использование которого рассчитаны n-day эксплойты.
Как выглядит работающий процесс на практике
Базовый процесс отслеживает, для каких пакетов есть доступные обновления, отличает рутинные обновления от критических исправлений безопасности, требующих более быстрой реакции, и по возможности тестирует изменения перед выходом в продакшн, а не применяет всё подряд сразу после выхода.
Рабочий процесс, который можно внедрить сегодня, описан здесь: руководство по управлению патчами сервера.
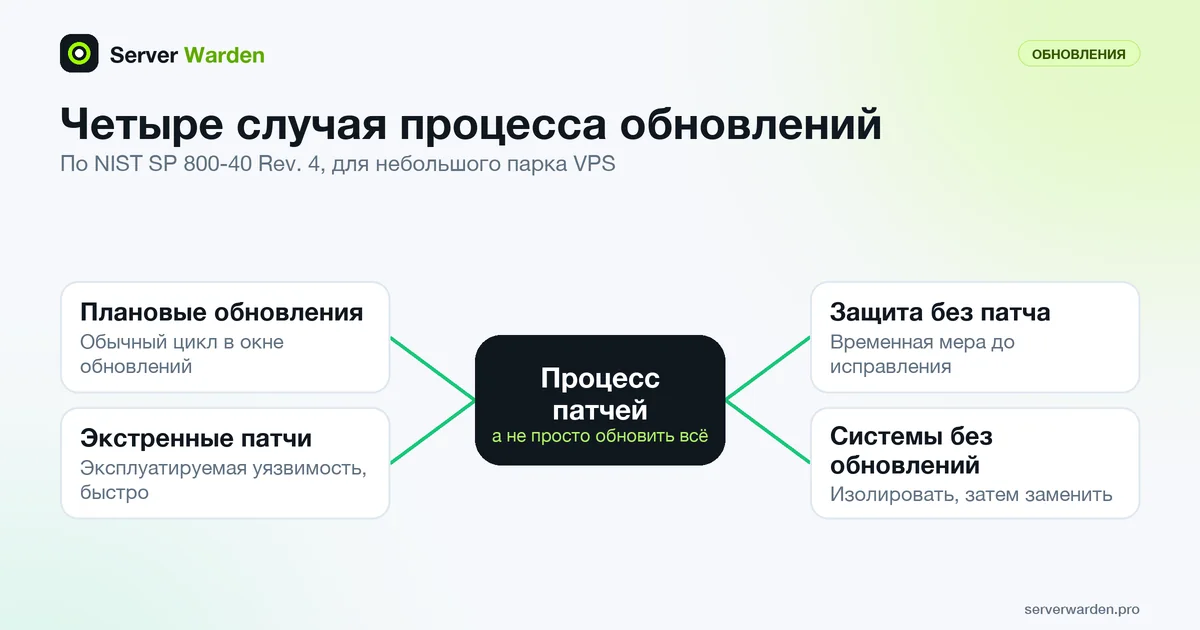
Четыре ситуации, которые должен закрывать процесс обновлений
Документ NIST SP 800-40 Rev. 4 предлагает заранее планировать четыре разных ответа вместо одной привычки "обновить всё". Применительно к небольшому парку Linux VPS это выглядит так:
- Плановые обновления: обычный цикл для рядовых обновлений, который проходит в назначенное окно обновлений.
- Экстренная установка патчей: серьёзная или уже эксплуатируемая уязвимость, например запись в каталоге CISA KEV для ПО, которое вы используете, устанавливается по заметно ускоренному графику.
- Экстренная защита без патча: временная мера, например отключение функции или закрытие порта, пока безопасного исправления ещё нет.
- Системы, которые нельзя обновить: системы, для которых вендор больше не выпускает исправления, например операционная система с закончившейся поддержкой. Для них NIST предлагает изоляцию и другие компенсирующие меры, а также план замены.
Документ также предупреждает, что откладывание плановых обновлений усложняет экстренные случаи: сначала приходится ставить прежние обновления, от которых зависят новые патчи. Накопившийся хвост обновлений сам по себе является риском, а не просто беспорядком в списке.
Как проверить, что ещё не установлено, включая перезапуски
Обновление пакета заменяет файлы на диске, но уже запущенная служба продолжает использовать старую библиотеку, пока её не перезапустят. Та же мысль есть в документации dnf needs-restarting: процессы часто нужно перезапускать, чтобы обновление безопасности вступило в силу. Поэтому полная проверка охватывает и пакеты, и процессы:
# Debian / Ubuntu
apt list --upgradable
sudo needrestart -r l
test -f /var/run/reboot-required && echo "reboot required"

# RHEL family
sudo dnf updateinfo list --security
sudo dnf needs-restarting -r
По описанию проекта needrestart, режим -r l только перечисляет затронутые службы и ничего не перезапускает, а ключ -k проверяет, не устарело ли ядро. В семействе RHEL команда dnf needs-restarting -r завершается с кодом 1, если нужна перезагрузка, что удобно для скриптов. Выполняйте эти проверки после каждого цикла обновлений, а остальную рутину берите из руководства по управлению патчами сервера. Полезное определение слова "готово" простое: ничего не ожидает установки, ничто не помечено для перезапуска и перезагрузка не требуется. Сервер, который не показывает неустановленных пакетов, но всё ещё работает на устаревшей библиотеке, на самом деле не обновлён.
Связанные термины: Live patching ядра, N-day эксплойт, CVSS (система оценки уязвимостей), Каталог KEV CISA (известные эксплуатируемые уязвимости).
В новостях: сентябрьские добавления в каталог KEV CISA включали уязвимость, которую использовали для reverse shell и майнинга криптовалюты, реальный пример того, почему скорость патчинга важна.
Часто задаваемые вопросы
Как часто нужно применять патчи?
Критические патчи безопасности нужно применять максимально быстро; рутинные обновления без отношения к безопасности могут идти по более медленному, запланированному графику, например еженедельному или ежемесячному окну обновлений.
Достаточно ли автоматического обновления само по себе?
Для большинства рутинных обновлений да, через что-то вроде unattended-upgrades. Критические исправления иногда всё же требуют более быстрого, вручную подтверждённого развёртывания, а не ожидания следующего автоматического цикла.
Какой риск слишком агрессивного обновления без тестирования?
Обновление иногда может сломать зависимость или конфигурацию; тестирование критических сервисов после крупных обновлений, особенно ядра или базы данных, снижает риск того, что само обновление вызовет простой.
Что делать с ПО, для которого больше не выходят патчи?
NIST SP 800-40 Rev. 4 называет такие системы необновляемыми активами и рекомендует изолировать их или применять другие меры защиты, пока готовится замена. На практике это переход на поддерживаемый релиз или, как минимум, максимально жёсткое ограничение сетевого доступа к такой системе.
Как установить только обновления безопасности на сервере семейства RHEL?
Выполните dnf upgrade --security: по документации DNF эта команда включает только пакеты, исправляющие проблему безопасности. Предварительно dnf updateinfo list --security покажет, какие рекомендации (advisories) ожидают установки.
Хотите увидеть, в каком состоянии ваш сервер?
Запустите бесплатную read-only проверку сервера или откройте Security Lab и посмотрите цикл обнаружение, сдерживание, восстановление, проверка в действии.
Получить бесплатную проверку сервераОткрыть Security Lab